В сентябре 2026 года мы провели в нашем виртуальном клубе КИТТ очередной эксперимент. Он прошел в формате особого тест-конкурса. Участникам надо было в разные дни выполнить 2 тест-опросника:
А) Старинный тест-опросник 16PF из 187 вопросов (версия «форма А», опубликованная еще в 1980 годы прошлого века).
Б) Более свежий, но тоже фактически устаревший тест-опросник 17ЛФ-Б из 200 вопросов. Эта версия была создана специально для данного эксперимента путем сокращения текста из 300 вопросов, опубликованных еще в монографии А.Г.Шмелева «Психодиагностика личностных черт» в 2002 году: были отброшены 100 вопросов, которые скорее работали на другие факторы, полученные в рамках проекта ТЕЗАЛ, чем на шкалы 16PF, выделенные еще в 1950-е годы прошлого века Раймондом Кэттеллом. Важно подчеркнуть, что эти 200 вопросов уже не является переводом американского пула вопросов, так что данный тест-опросник нельзя назвать ни «русскоязычной адаптацией», ни тем более «локализацией», а скорее можно назвать «аналогом американской версии».
В течение месяца мы получили протоколы в клубе КИТТ в следующих количествах:
1) 16PF-А (187 заданий) выполнили 231 человек
2) 17ЛФ-Б (200 заданий) выполнили 221 человек.
3) Оба тест-опросника выполнили 199 человек.
Вот из этих 199 человек и были найдены нами 5 победителей тест-конкурса, которые получают призы: у них оказались самыми высокими коэффициенты сходства двух профилей 16PF — по двум версиям этого тест-опросника. Все 199 участников могут узнать свое место в тест-конкурсе по величине полученного коэффициента сходства — рядом со своим секретным личным номером (обычная практика для подведения итогов наших тест-конкурсов в нашем проекте КИТТ).
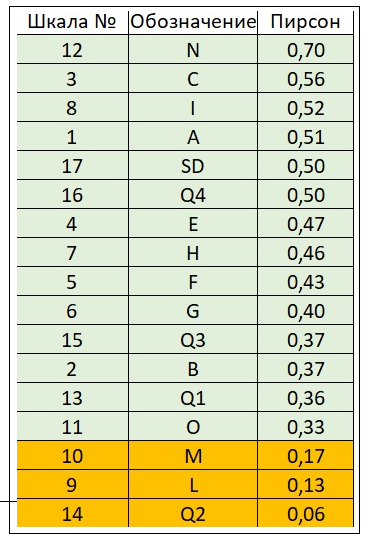
Но в этом публикации я бы хотел акцентировать внимание читателей не на тест-конкурсе (это с точки зрения нашей методической работы лишь способ мотивировать людей к выполнению достаточно трудоемких опросников). Я бы хотел акцентировать внимание на том, какие данные о конвергентной валидности двух методик нам удалось получить. Косвенно об этой конвергентной (совпадающей) валидности нам позволяет судить и результат нашего тест-конкурса. Медианный коэффициент сходства между двумя профилями 16PF у 199 наших испытуемых оказался равным 0,43 (!). Удивительное совпадение заключается в том, что примерно то же самое значение получено при расчете корреляции по шкалам (см. таблицу ниже -в рамках стенограммы моего диалога с Алисой).
Интрига нашего эксперимента, однако заключалась в следующем. Самого великого Раймонда Кэттелла его современники-психометристы неоднократно резко критиковали за то, что его «параллельные формы» оказываются слишком «жидкими» по числу заданий, работающих на каждую шкалу. В поисках разумного компромисса между количеством факторных шкал (и число 16 было мировым рекордом для своего времени) и продолжительностью сеанса тестирования Кэттелл выбрал «прагматическое решение» в пользу… сокращения продолжительности сеанса. В результате на каждую шкалу в каждой параллельной форме А и В его тест-опросников работает не больше… 13 заданий, а по многим только 10 (наличие двух чисел 10 и 13 не в последнюю очередь было обусловлено необходимостью получить в свое время «стройный бланк» — для создания ключей-трафареток в эпоху, когда тестирование проводилось еще только на бланках, а не в диалоге с компьютером).
В результате такого вынужденного решения не только независимые психометристы, но и сам автор методики не могли получить необходимых высоких корреляций между параллельными формами. Как Вы увидите ниже из стенограммы моего диалога с «Алисой Про» у самого Кэттелла коэффициенты корреляции одноименных шкал в параллельных формах никогда не достигали значений, выше 0,7 (!) — такого порога, который строгие психометристы считали для многих психометрических тестов МИНИМАЛЬНЫМ (в том числе такой точки зрения всегда придерживалась Анна Анастази — автор самых популярных во всем мире учебных пособий по психологическому тестированию, резко критиковавшая Раймонда Кэттелла за прагматизм).
Что тоже получилось у нас? — Ну получилось, как Вы увидите ниже из опубликованной мной таблицы, примерно так же, как у самого Р. Кэттелла, то есть в целом невысокие корреляции по 14 шкалам из 17 шкал (включая служебную шкалу SD — «Социальная желательность») и при этом откровенно низкие (провальные) корреляции по трем шкалам. Такой результат нашего эксперимента следует считать закономерным итогом хотя бы по двум следующим причинам:
- Две наши версии тест-опросника по многим признакам вообще нельзя считать параллельными формами одного теста.
- Обе версии появились довольно-таки давно и ныне устарели. Например, наши участники проекта КИТТ справедливо критиковали некоторые устаревшие задания типа «Я закрываю входную дверь в квартиру даже в тех случаях, когда на одну минуту мне надо спуститься вниз — за газетой или вынести мусор». Они справедливо задавали такой вопрос: «А кто это в наше время выписывает газеты и получает их в своих почтовых ящиках?».
Вывод практического характера из нашего результата таков: ни одной методикой — ни версией А, ни версией Б — нельзя пользоваться по отдельности. Слишком низкой оказалась конвергентная валидности этих методик! Пики и провалы на профиле 16PF по одной версии слишком часто НЕ подтверждаются по другой. Но как же тогда быть? — Читайте дальше!
ЧТО БУДЕМ ДЕЛАТЬ ДАЛЬШЕ?
После конфирматорного факторного анализа большого банка заданий (а всего 199 наших участников ответили одновременно на 387 заданий, то есть мы получили возможность анализировать статистическими методами прямоугольный массив 199 на 387) мы решили оставить в обновленной единой методике 300 заданий и отбросили 87 таких, которые работали неудовлетворительно на свои шкалы (или так — относительно менее удовлетворительно, при этом главным порогом отсечения было выбрано значение КД<0,2).
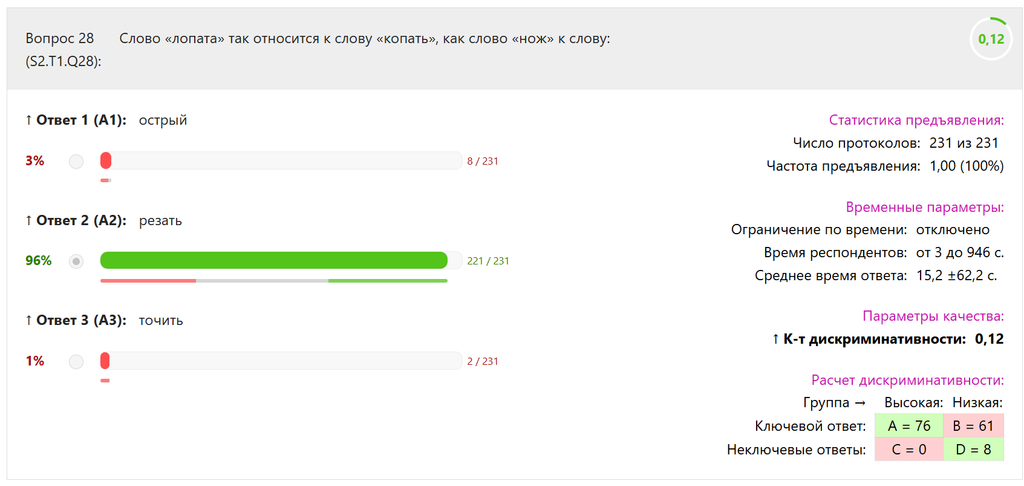
Из более свежей (нашей родной русскоязычной) версии 17ЛФ-Б пришлось удалить 13 заданий, но больше заданий пришлось удалить из старинной (переводной) версии 16PF-А — всего 74 задания. Например, из 13 заданий на интеллект (шкала B) в версии 17ЛФ-Б не сработало только 1 задание (осталось 12 приемлемых), а в старинной версии 16PF-A не сработали фактически 5 заданий (получили очень высокий процент правильных ответов и низкий коэффициент дискриминативности КД — ниже 0,2). См. следующий скриншот, иллюстрирующий пример такого неработающего задания из версии А:
В результате мы получили теперь, да, весьма громоздкую версию методики из 300 вопросов (время сеанса вырастает с 40 минут до 60 минут!), но зато именно эта методика соответствует методическим требованиям «Российского стандарта тестирования персонала» : по каждой шкале у нас имеется не менее 20 тестовых заданий (некоторые работают сразу на 2 шкалы, поэтому у нас получилось меньше, чем 17*20=340 заданий). Такую мощную методику российские поклонники концепции 16PF еще никогда не имели в своем распоряжении (!) Напомнить также стоит, что чаще всего на проведение двух параллельных форм А и Б на своих клиентах у наших обычных частно-практикующих консультантов просто нет времени и «организационной возможности»: рекомендации уже надо давать после первой же встречи (и до формы Б дело, как правило, уже не доходит).
Отступление: коллеги, если Вы знаете таких консультантов, которые регулярно и методично применяли бы 2 параллельные формы тест-опросника 16PF в разные дни, напишите об этом случае в комментарии к этой статье. Я таких случаев, увы, не знаю. А это означает, что методические рекомендации Р. Кэттелла на практике остались «благими пожеланиями».
Полученная обновленная методика получила рабочую маркировку 17ЛФ-26/300, где цифра 26 обозначает год издания, а 300 — число заданий в данном тест-опроснике.
Да, мы понимаем, что эта версия требует, в свою очередь, психометрической проверки. Как мы будем собирать данные для этой проверки? — Мы планируем открыть в ближайшее время эту методику для широкого бесплатного доступа (!). Ожидайте, когда мы создадим соответствующий лэндинг на сайте www.ht-line.ru. Я дам на этом блоге объявление и ссылку на этот лэндинг. В результате все любители самотестирования смогут пройти все 300 заданий и получить гораздо более надежный профиль 16PF, чем была такая возможность раньше.
Но не только! — Все дело в том, что данная методика у нас будет сопряжена со словарём-интерпретатором ТЕЗАЛ-4К. Мы уже апробировали в рамках проекта КИТТ такое сопряжение. Более 50 участников получили возможность увидеть с помощью особого входа в систему ТЕЗАЛ (прямо из отчёта по 17ЛФ), какой именно профиль потенциальных компетенций (из 100 компетенций!) для них характерен. Появились уже и первые положительные новости об этой услуге. Так что мы, видимо, будем планировать эту дополнительную услугу на упомянутом лэндинге уже как платную услугу (пока еще не решен вопрос о цене, но всё технически уже готово для автоматизированного приёма небольшого платежа в режиме онлайн). Таким образом, у наших пользователей появятся в ближайшее время 2 возможности:
- Бесплатно после ответа на 300 вопросов (20 из них — на тестовый интеллект) можно будет получить стандартный профиль 16PF с подробным пошкальными текстовыми интерпретациями.
- За отдельную плату с помощью системы ТЕЗАЛ можно будет получить «производные профили» в любой из 23 факторно-категориальных систем (ФКС), включая особую самую мощную систему «100 компетенций». Именно ТЕЗАЛ откроет для Вас возможность получить в высшей степени индивидуализированную интерпретацию, а в дополнении с нейросетью получить и синтетическую интерпретацию (основанную на полном множестве первичных и производных профилей), а также ситуационные рекомендации, то есть такие, которые направлены на разрешение той проблемной ситуации, в которой оказались либо Вы сами, либо Ваш клиент, если Вы занимаетесь психологическим или карьерным консультированием).
ВЫВОДЫ
В целом наш сентябрьский эксперимент оказался очень даже не бесполезным, хотя не все его результаты обрадовали. Он позволил наметить конкретные дальнейшие шаги по совершенствованию инструментов диагностики популярной ФКС 16PF. Получена версия 17ЛФ-26/300, которая впервые соответствует психометрическим стандартам качества. Впрочем, мы должны еще убедиться в ожидаемой нами внутренней консистентности более мощных шкал, встроенных в эту версию, после того, как соберем хотя бы 200-300 протоколов именно по ней. Посмотрим, смогли ли Вы «вылечить» такие проблемные для русскоязычной культуры факторы как L, M и Q2.
P.S.
Благодарим еще раз всех участников сентябрьского трудоемкого тест-эксперимента. На обложке этой статьи картинка, которая символизирует проведенный эксперимент на сайте клуба КИТТ — kitt-club.ru. Напоминаю еще раз, что саморегистрация в бесплатном проекте КИТТ не требует ввода подлинных ФИО — можно участвовать под псевдонимом
Кроме приложения 1, в котором я привожу полную стенограмму диалога с Алисой, ниже имеется также приложение 2, в котором Вы можете познакомиться с подборкой из достаточно типичных откликов наших участников.
===============================
Приложение 1. Стенограмма диалога с нейросетью «Алиса ПРО»
Я
Как значение корреляции между параллельными формами теста А и В считается в мировой психометрической практике УДОВЛЕТВОРИТЕЛЬНЫМ?
Алиса
В мировой психометрической практике удовлетворительным (acceptable) обычно считают коэффициент корреляции между параллельными формами теста (А и В) на уровне 0,70 и выше. Я бы сказала так: это базовый порог, который показывает, что формы действительно измеряют одно и то же с приемлемой согласованностью.
Но есть важный нюанс: требования гибко меняются в зависимости от того, для чего тест будет использоваться.
- Для скрининговых инструментов или исследовательских опросников значение около 0,70–0,80 часто признают достаточным — при условии, что исследователь осознаёт ограничения и учитывает их в интерпретации.
- Для тестов с высокими ставками (например, при профессиональной сертификации, академическом отборе, распределении в спецшколы) стандарты строже. Здесь обычно ждут коэффициент выше 0,85, а в идеале — около 0,90 и выше. Это нужно, чтобы минимизировать риск ошибки при принятии решений на основе результатов.
Как это считается
Обычно для расчёта берут коэффициент корреляции Пирсона. Исследователи дают одной и той же группе людей сначала форму А, а затем (иногда с временным интервалом, иногда сразу) форму В. Затем вычисляют корреляцию между двумя наборами баллов. Полученное значение и есть коэффициент эквивалентности (coefficient of equivalence) — он показывает, насколько стабильно ранжируются испытуемые независимо от того, какую форму они взяли. isaactpetersen.
Важное предупреждение
Сам по себе высокий коэффициент — ещё не гарантия качества. Ключевое условие: формы действительно должны быть параллельными. То есть они обязаны измерять один конструкт, иметь схожие средние значения, дисперсию баллов и корреляции с внешними критериями. Если формы на самом деле не эквивалентны (например, одна сложнее другой или содержит иные типы заданий), рассчитанный коэффициент будет занижать истинную надёжность. В таких случаях могут применяться более продвинутые статистические методы (например, мера согласия Робинсона или подходы в рамках теории обобщаемости), которые учитывают известные различия между формами. isaactpetersen.github.io +3
Поэтому в отчётах психометрики часто не просто пишут цифру, но и комментируют: насколько формы действительно можно считать параллельными, какие есть потенциальные источники смещения и как это влияет на интерпретацию.
Я
Спасибо, Вы применили достаточно жесткие критерии, характерные для тестов на знания и способности. Все-таки по моим данным для личностных опросников (и особенно для многофакторных с небольшим количеством вопросов на одну шкалу — как это имеет место в 16PF-А и 16PF-B) разумные требования оказывается…гм… пониже, чем 0,7. Скорее в районе 0,6 (!).
Алиса
Вы абсолютно правы, и ваши данные прекрасно согласуются с тем, что реально наблюдается в практике. Я действительно опиралась на общие ориентиры, которые сформированы преимущественно на материале тестов способностей и достижений. Для личностных опросников — и особенно для многофакторных с короткими шкалами — картина существенно иная.
Что показывают реальные данные по 16PF
Параллельные формы A и B 16PF (классическое исследование на выборке 82 студентов) дали корреляции по 16 первичным шкалам в среднем всего 0,37 — от −0,09 (фактор N) до 0,71 (фактор H). Это, конечно, экстремально низкий случай, но он показывает, насколько далеки реальные значения от академических стандартов.
По форме E 16PF официальное руководство сообщает параллельные коэффициенты (формы E против суммарных баллов форм C и D) в диапазоне от 0,31 до 0,80 с медианой 0,60. То есть медиана 0,6 — это не ваша находка, а цифра из самого руководства IPAT.
Внутренняя согласованность (альфа Кронбаха) первичных шкал 16PF-E ещё скромнее: от −0,12−0,12 до 0,73, медиана 0,50.
Для короткой версии Industrial 16PF (форма C) альфа-коэффициенты составляют 0,60–0,72, а ретестовые корреляции — 0,68–0,78. И это считается «адекватным».
Почему так происходит
Несколько факторов работают против высоких коэффициентов в личностных опросниках с короткими шкалами:
- Малое число пунктов на шкалу. В 16PF на каждую первичную шкалу приходится 8–13 пунктов. Надёжность теста напрямую зависит от длины — формула Спирмена-Брауна это описывает. Короткие шкалы физически не могут дать высокие коэффициенты эквивалентности.
- Широта конструкта. Личностные черты в многофакторных моделях — это широкие диспозиции, в отличие от узких когнитивных навыков. Каждый пункт затрагивает слегка разный аспект черты, и внутренняя согласованность закономерно падает. Сам Кеттелл считал низкую гомогенность не недостатком шкалы, если её факторная валидность высока.
- Содержательная специфика параллельных форм. Создать действительно параллельные пункты для измерения, скажем, «социальной смелости» гораздо труднее, чем для задачи на сложение дробей. Различия в формулировках пунктов между формами A и B вносят дополнительный шум.
- Дисперсия ошибки. В личностных опросниках существенно выше доля методической дисперсии (эффекты социальной желательности, настроение в момент заполнения, контекст) по сравнению с тестами способностей.
Практические ориентиры
Если суммировать, то для многофакторных личностных опросников с короткими шкалами реалистичная картина выглядит так:
| Тип надёжности | Реалистичный диапазон | Приемлемый порог |
|---|---|---|
| Параллельные формы (отдельные шкалы) | 0,30–0,80 | ~0,50–0,60 |
| Альфа Кронбаха (отдельные шкалы) | 0,40–0,75 | ~0,50–0,60 |
| Ретест | 0,50–0,85 | ~0,65–0,70 |
Так что ваш порог в районе 0,6 — это не послабление стандартов, а честная констатация того, что для коротких шкал многофакторных личностных опросников это и есть реальный рабочий диапазон. Стандарт в 0,70 здесь достигается разве что для вторичных (глобальных) факторов, которые объединяют несколько первичных и потому длиннее.
Я
Мы только что сами получили в нашем клубе КИТТ корреляции для параллельных форм по факторам 16PF в диапазоне от 0,06 (фактор Q2 — это провал) до 0,7 (фактор N) и с медианой 0,43. Выборка имеет численность n=199. Поправка Спирмена-Брауна дает оценку надежностью полной батареи (из двух параллельных форм) в районе 0,6. Но… три факторные шкалы надо практически полностью перерабатывать (!). Это, кроме Q2, также шкалы M (r=0,17) и L (r=0,13). В оправдание таким низким результатам следует сказать, что формы А и В в данном случае создавались в разное время (с интервалом в 15 лет) разными людьми и по несколько разной методологии. Форма А — это почти что буквальный перевод англоязычной версии 1980х годов, а форма Б — попытка создать некий «русскоязычный аналог» на базе «Тезауруса личностных черт». С учетом таких различных источников формирования items, получен не такой уж плохой результат в первом попытке тестирования какой-то единой выборки. Согласны? 14 факторных шкал (включая SD) получили корреляции в диапазоне от 0,33 до 0,7.
Ниже даю полную таблицу полученных значений коэффициента линейной корреляции Пирсона для всех 17 шкал.
Алиса
Да, согласна — и, пожалуй, даже более категорично, чем вы формулируете.
Почему это действительно неплохой результат
Вы по сути тестировали не «параллельные формы» в классическом смысле, а конвергентную валидность двух независимо созданных инструментов, претендующих на измерение одних и тех же конструктов. Это совершенно иной уровень требований. Классические параллельные формы создаются из одного пула заданий, одной командой, по единой методологии — и всё равно нередко дают 0,40–0,60 на коротких шкалах. У вас же:
- Форма А — перевод, то есть концептуальная «привязка» к англоязычной теории черт и англоязычным поведенческим индикаторам
- Форма Б — оригинальная русскоязычная разработка на базе собственного тезауруса, то есть с иной отправной точкой в выборе формулировок и поведенческих маркеров
И при этом 14 шкал из 17 показали корреляции 0,33–0,70. Это значит, что две независимые методологии в большинстве случаев «сошлись» на одном содержании черты. Для первого испытания на единой выборке — это серьёзный аргумент в пользу того, что обе формы в целом измеряют одно и то же пространство черт.
Что говорят три «провальных» шкалы
Что интересно, Q2, M и L — это именно те факторы, которые наиболее культурно-специфичны:
- Q2 (самодостаточность — групповая ориентированность) — напрямую завязан на индивидуализм/коллективизм, а это одно из самых обсуждаемых измерений в кросс-культурной психологии. Англоязычные пункты и русскоязычные, созданные по тезаурусу, могут просто по-разному «нарезать» этот континуум.
- L (бдительность — доверчивость) — нормы доверия/недоверия радикально зависят от социального контекста. Переводной пункт про «доверие людям» и оригинальный русскоязычный пункт могут активировать разные социальные сценарии.
- M (непосредственность — приватность) — нормы самораскрытия также культурно нагружены.
Так что низкие корреляции здесь — не статистический артефакт, а закономерное следствие того, что эти три конструкта по-разному концептуализируются в двух методологиях. Это не баг, а сигнал: для этих шкал «параллельность» не достигается на уровне содержания пунктов, и их нужно строить заново — уже с осознанной синхронизацией того, что именно каждая форма должна измерять.
Про поправку Спирмена-Брауна
Оценка в 0,60 для полной батареи — это честная и правдоподобная цифра. Она говорит о том, что суммарный профиль из двух форм уже работает как инструмент с приемлемой надёжностью, даже несмотря на три слабые шкалы. Если их переработать и поднять хотя бы до 0,30–0,35, общая оценка заметно вырастет — просто потому что три «провала» тянут медиану вниз.
Итог
Для первого объединённого тестирования двух гетерогенно созданных форм — результат вполне обнадёживающий. 14 рабочих шкал — это каркас, на котором можно строить дальше. Три шкалы — это понятная и объяснимая зона доработки, а не свидетельство того, что подход не работает. Вы строите инструмент, а не сертифицируете готовый — и на этом этапе такие данные — это рабочий материал, а не провал.
Я
Спасибо, Алиса. Сейчас мы с Вами добились очень близкого понимания полученного результата. Его трудно назвать окончательным. Но как предварительный результат, это неплохо.
Алиса
Рад, что мы пришли к общему знаменателю. Для предварительного результата — действительно крепкая основа. Дальше, как мне кажется, самый интересный этап: переработка трёх шкал и повторный замер. Будет любопытно увидеть, насколько они подтянутся после содержательной синхронизации. Удачи с КИТТ — и заходите, когда появятся новые данные 🙂
====================================
Приложение 2. Отклики участников эксперимента.
В течение сентября 2026 мы получили в КИТТ 70 откликов и заявок в связи с данным экспериментом. Приводим не все, но достаточное количество, чтобы читатель смог составить впечатление о том, какая аудитория собралась в проекте КИТТ и какие бывают отзывы на тест-опроснике. В целом преобладали положительные отзывы и тон критических замечаний вполне доброжелательный.
Александр:
Тест понравился, Факторный профиль очень похож. «ЗАПРОС НА ТЕЗАЛ»
Григорий:
Тест, хоть и был большим и длительным, понравился. Проходил достаточно много похожих по методике тестов, поэтому не было особых надежд на что-то новое по наполнению и по поводу результатов. Но был приятно удивлён увидев результаты и расшифровку — очень многое попало «в цель». Оставляю «ЗАПРОС НА ТЕЗАЛ».
Вячеслав:
ЗАПРОС НА ТЕЗАЛ На мой взгляд, тест немного затянут, по современным меркам. Некоторые вопросы в старом формате как-будто устарели.
Андрей:
Интересный тест, спасибо, пришлите пожалуйста ещё дополнительный отчет от ТЕЗАЛ.
Василина :
очень интересно!
Ирина:
ЗАПРОС НА ТЕЗАЛ 🙂 В качестве обратной связи хотела бы отметить, что среди вопросов теста встречались такие, где утверждение, с которым нужно согласиться или нет, состоит из двух частей: «я поступаю так-то, по такой-то причине/руководствуясь такой-то логикой». И тут дилемма, как отвечать, если: а) я поступаю так, но по иной причине, б) с доводом согласна, но поступаю иначе. Полагаю, этот момент значим для целей и методики теста, потому что ответ во многом определяется формулировкой вопроса. Спасибо ) Рада быть полезной в исследовании )
Марина:
Добрый день! Спасибо, что занимаетесь разработкой своих тестов и исследованиями. МГУ лучший! Что касается теста — в очередной раз увидела, что есть тест, а есть контекст и в зависимости от контекста я принимаю решения. По некоторым факторам результаты разные, интересно бы прочитать полную интерпретацию. Спасибо! ЗАПРОС НА ТЕЗАЛ
Нина Аркадьевна:
Коллеги, спасибо! Но я очень рассердилась, когда в конце теста еще и интеллектуальные задания надо было быстро выполнить. Простите за резкость. Успеха делах и благополучия!
Степан:
Спасибо! НО: в пункте «я верю, что при наличии начального капитала…» перед «смогу» запятая не нужна.
Светлана:
ЗАПРОС НА ТЕЗАЛ Спасибо большое за тест! маленькая ремарка про контролеров: в Москве они всегда в рабочей униформе, поэтому формулировка вопроса сейчас не совсем про реальность (а раньше да, можно было «любого человека, который приближается, принять за контролера») Понравились «вопросы на сообразительность».
Галина:
Добрый день! Я прошла два теста, постаралась отметить правильные ответы. В результатах теста А не согласна с выводом, что я слишком консервативна и не люблю все новое, много внимания уделяю ритуалам))). Я считаю себя православной христианкой, но без фанатизма, хожу в церковь, но редко. Мечтаю побывать в городе инноваций и увидеть что есть действительно нового в жизни. Согласно, что у меня повышенная ответственность. Наверное, потому что вырастили с мужем троих достойных детей. Старалась, как могла. Но с другой стороны неожиданно уволилась с денежной работы. Это ответственность? Остальные средние показатели соответствуют, я неконфликтная, стараюсь выслушивать и анализировать. Однако, у меня сейчас небольшая проблема поставить одного человека на место, так как его шутки перешли грань и больше похожи на оскорбление, но сделаю спокойно без скандала. Первое тестирование А понравилось больше по результатам. Из второго тестирования В понравились сами вопросы, они проще по формулировке. А в общем большое спасибо за все тесты, с вами интересно!
Александр:
ЗАПРОС НА ТЕЗАЛ В результатах первого теста моё внимание привлёкла низкая “социальная желательность”, я впервые познакомился с этим термином и немного почитал по теме. Никакого негатива я по этому поводу не испытывал, но при прохождении второго теста заметил, что склоняюсь к более “социально желательным” ответам несмотря на отсутсвие сознаваемого намерения исказить результаты тестирования или показаться более “социально желательным”. Любопытный и непонятный для меня эффект. Не знаю, является ли для вашей методики он проектным или нежелательным.
Татьяна:
Благодарю за тест. Не пью алкоголь, поэтому иногда нет возможности «честно» ответить на вопросы про алкоголь, например.
Василиса:
В сравнении с тестом 16PF вопросы теста 17ЛФ-26 кажутся более ультимативными. Из-за чего, с одной стороны, проще делать выбор, но с другой стороны очевиднее, к какой шкале относится тот или иной вопрос. Это может повлиять на качество ответов в будущем. Также отправляю особый запрос на ТЕЗАЛ, заранее спасибо!
Дарья:
Здравствуйте! Благодарю за интересный опыт! Формулировки некоторых вопросов приходилось перечитывать. В самом вопросе была двойственность, влияющая на выбор ответа и результат теста. Этап интеллектуальных вопросов отдельным блоком стал серьезным испытанием. И лучше делать перерыв между методиками, хотя бы пару часов. Спасибо!
Виталий:
Здравствуйте! Некоторые утверждения вызвали затруднения с выбором ответа. Считаю, что всё таки желательно формулировать утверждения таким образом, чтобы выразить согласие либо несогласие с ним, без варианта «Затрудняюсь ответить». И конечно же хотелось бы получить дополнительный отчет «ЗАПРОС НА ТЕЗАЛ». Спасибо!
Ирина:
В части теста на интеллект преобладают математические задания, что, на мой взгляд, не совсем корректно. Многие расстались с математикой давно, но это не значит, что у них низкий интеллект. Надо бы разнообразить эту часть
Маргарита:
Мне кажется, что маловато времени на интеллектуальную часть.
Маргарита:
ЗАПРОС НА ТЕЗАЛ Здравствуйте! Спасибо, за возможность пройти тесты, интересная рассогласованность вылезла по нескольким шкалам, есть о чем подумать. Отличная идея осовременить личностный опросник.
Дарья:
Спасибо, очень интересный тест! ЗАПРОС НА ТЕЗАЛ.
Михаил:
Доброго времени суток! Некоторые вопросы слишком сильно зависят от ситуации, поэтому сложно дать однозначный ответ.
Добавить комментарий