Итак, коллеги, настал подходящий момент поговорить о поправке на случайное угадывание в тестах с выбором ответа. Я поискал в статьях этого блога, шла ли где-то об этом речь раньше (уже не помню, конечно, содержание всех 575 опубликованных здесь статей), и увидел, что об этом НЕТ еще здесь каких-либо материалов (!).
Надо сказать, что в большинстве кадровых конкурсов (включая такой флагманский конкурс как «Лидеры России») такая поправка не применяется. Почему? — Потому что цель любого конкурса — это отделить сильных от слабых, а поправка НЕ меняет порядок следования участников по убыванию процентильного балла по тесту. Поэтому достаточно отранжировать (отсортировать) участников по убыванию обыкновенного ППО — балла, отражающего «процент правильных ответов».
Но… есть задачи, когда поправка просто необходима (!). Такие задачи, когда нам нужен не завышенный, а истинный балл ППО. И такой задачей является измерение словарного запаса. Чтобы сам участник тестирования не обманывался насчет завышенного балла, нужно применить несложную формулу в виде дроби, в которой в числителе эмпирический балл ППО снижается на величину «вероятность случайного угадывания», а в знаменателе присутствует максимально возможный скорректированный балл ППО (то есть, 100% минус процент случайного угадывания, который в случае четырех ответов равен 25%). Ниже в таблицах Вы увидите не только точную формулу, но и то, как практически работает эта простая формула на числовых значениях.
9 ноября мы запланировали в нашем клубе КИТТ открыть пилотное тестирование по методике VOCAMETER, так что каждый, кто зарегистрирован на сайте kitt-club.ru, сможет измерить свой «рецептивный словарь» — необходимый для чтения и прослушивания адаптивных текстов на английском языке (текстов определенной трудности). Ниже я решил опубликовать прямо здесь короткие методические указания по этой нашей новой методике — одной из методик в пакете «Тест-прогресс», пилотирование которого мы когда-то начали в КИТТ еще с конкурсов типа «Шахмаш» ( срешения шахматных этюдов). Специфика этих тест-конкурсов заключается в том, что мы проводим не однократное тестовое измерение, а, как минимум, два среза и смотрим, имеется ли рост результатов через 2 недели или через месяц.
ВНИМАНИЕ: в программе Ht-Line объем вашего вокабуляра пока еще рассчитывается по упрощенной формуле. В этом случае по каждому тесту возрастающей трудности ВКЛАД = ВЕС * ППО. Но в будущем мы планируем внедрить автоматическую поправку на случайное угадывание (если методика VOCAMETER станет популярной).
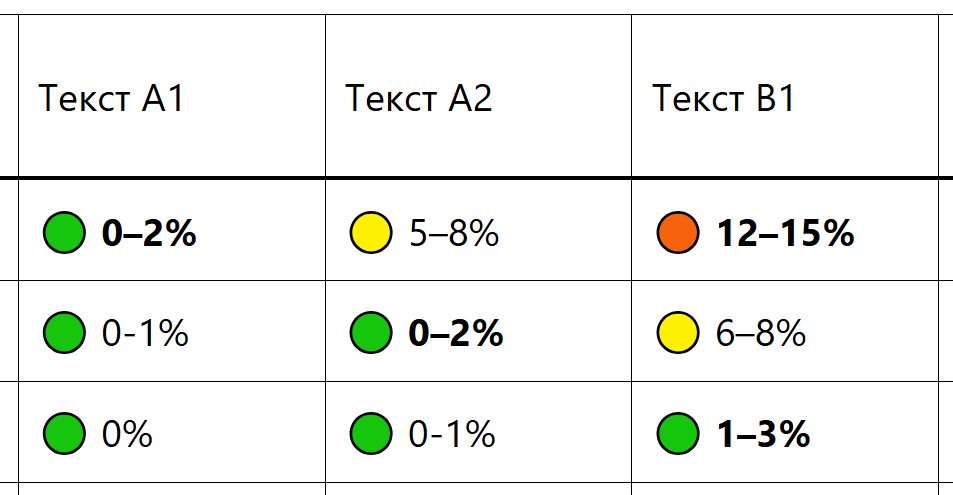
Картинка на обложке этой статьи — это фрагмент заключительной таблицы 3, которую Вы найдете в самом конце наших методических указаний. Эта таблица будет особенно полезной для Вас, если вы найдете «свою строку», предварительно выполнив поправку на случайное угадывание. Эта поправка тем сильней снижает истинное значение ВКЛАДА (по сравнению с номинальным), чем ближе ваш эмпирический балл ППО приближается к уровню случайного угадывания. Поправку надо бы применять уже тогда, когда эмпирический ППО оказывается ниже 75%. Ведь в этом случае истинный вклад составляет меньше двух третей от номинального вклада.
Приглашаем к апробации методики всех, кто заинтересован в росте своего запаса слов в международном английском. В ходе нашего ноябрьского тест-конкурса призовой фонд предусмотрен вовсе не для тех, у кого словарный запас окажется больше, а для тех, кто выполнит все тесты из серии А и серии Б и при этом напишет внятную рецензию, содержащую как похвалы, так и критику 🙂
P.S.
Имеется ли еще одна чисто субъективная причина в том, что появилась методика VOCAMETER? Да, конечно, имеется. Я (Шмелев А.Г.) неоднократно пытался измерить собственный словарный запас в английском языке и писал тут уже не раз о том, какой чудовищных разброс в моих результатах получается с помощью доступных мне тестов (прежде всего на сайте puzzle-english.com). То объем рецептивного (пассивного) словаря приближается к 20 000, то к 7 тысячам (?!). Из горячего в холодное…
Но я-то чувствую, что мой истинный объем лежит где-то в пределах 9-10 тысяч слов (даже несколько ниже среднего показателя по всем сеансам тестирования на puzzle-english). Вот такой приблизительно результат я лично и получил с помощью методики VOCAMETER. Причем с использованием формулы, учитывающей поправку на случайное угадывание (ибо на уровне С1 мой результат оказался-таки ниже ППО=60%). Так что истинный объем моего вокабуляра соответствует текстам с уровнем трудности B2, но не С1, что полностью соответствует моим «ощущениям»: беру С1 и чувствую неприемлемый дискомфорт, но когда беру B2, то легкий дискомфорт временами возникает тоже, но вполне приемлемый — тот самый, который содействует прогрессу (наращиванию пассивного словаря). В таблице 3 вы видите, какой процент ошибок допустим для полезного и комфортного обучающего чтения (слушания аудиокниги), а какой — это только зря потраченное время.
Для интересующихся историей моего эксперимента по наращиванию словарного запаса даю ссылки на соответствующие мои статьи на этом блоге:
===================================================
© Инновационный центр «Гуманитарные технологии», 2026
Методика VOCAMETER – измеритель словарного запаса (на материале английского языка)
Назначение методики
Методика VOCAMETER предназначена для самостоятельного измерения пользователем объема своего пассивного словаря (вокабуляра). Методика позволяет определить, какой уровень трудности адаптированных текстов на английском языке в настоящий момент следует выбирать, так чтобы чтение (или прослушивание аудиокниги) было комфортным и полезным, то есть содействовало быстрому наращиванию вокабуляра, а не перегружало память обилием новых, незнакомых слов.
Структура и формат методики VOCAMETER
Полный комплект тестов первой версии – это 2 серии А и Б, включающие по пять тестов возрастающей трудности для пяти стандартных уровней освоения языка, принятых в международных стандартах языкового образования: А1-А2-B1-B2-C1. Начинать надо всегда с теста на уровень А1, а затем повышать трудность. Каждый тест включает 30 английских слов и требует выбора из четырех готовых вариантов перевода на русских язык.
От испытуемого требуется скоростной режим выполнения тестовых заданий, имитирующий беглое чтение и быстрое понимание, поэтому в тесте используются посекундные ограничения времени на ответ (отсутствие ответа в заданное время означает ошибку). Расчетное время выполнения всех тестов (от более легких к более трудным) от 3 до 10 минут. Таким образом, время на выполнение первой серии А из пяти тестов возрастающей трудности (включающих в общей сложности 150 заданий) занимает от 15 до 25 минут. Параллельную серию Б, предназначенную для более надежного измерения словарного запаса, рекомендуется выполнять в другой день. Она тоже займет приблизительно от 15 до 25 минут.
ВАЖНАЯ ОГОВОРКА ДЛЯ НАЧИНАЮЩИХ: предлагаемая формула подсчета объема словаря (вокабуляра) не требует от Вас выполнения всех методик в серии. Если Вы сами уже знаете, что находитесь на уровне не выше А2 и Вам бесполезно выполнять тест на уровне B1, то Вы можете потратить всего лишь 5 или 10 минут на выполнения первых двух тестов и не выполнять три последующих. Ниже приводится алгоритм подсчета объема по таблице, который гибко позволяет учитывать результат только по тем тестам, которые выполнены.
Альтернатива: существующий с давних пор популярный метод измерения готовности к чтению адаптированной литературы предполагает выписывание (сохранение в электронном блокноте) самим испытуемым всех незнакомых слов на нескольких страницах очередного текста и примерный расчет процента этих слов по отношению к общему количеству слов на этих страницах. Практика показывает, что подобный метод приводит не только к бОльшим затратам времени (фактически к часам, а не к минутам) но и порождает очень неточную оценку, связанную со специфической лексикой отдельного текста (книги) и отдельного автора. На самом деле требуется не менее 3-5 книг, выполненных в различных жанрах художественной, публицистической и научно-популярной литературы, чтобы оценить свой вокабуляр с такой точностью, с какой это позволяет сделать специализированный измерительный тест, построенный по принципам научной тестологии (психометрики).
ВАЖНАЯ СПРАВКА: триста слов, использованных в нынешней первой версии методики VOCAMETER, подобраны не только с учетом разнообразной тематики, но и на основе авторитетных, статистически репрезентативных и современных частотных словарей английской лексики, доступных в Интернете (один из них – это проект BNC/COCA word family lists, в котором 25 тысяч словарных семейств отнесены к «полосам частности» по одной тысячи слов в каждом).
Формула и таблицы для самостоятельного подсчета словарного запаса
По каждому выполненному тесту испытуемый получает простой и понятный балл ППО (процент правильных ответов) и для самостоятельного расчета своего словарного запаса может воспользоваться примерами расчетов в следующих таблицах 1 и 2. Мы (авторы методики VOCAMETER) считаем методически правильным не прятать наш расчет объема «под капотом» закрытой от пользователя компьютерной программы, а, напротив, ознакомить с простейшим алгоритмом, чтобы повысить у наших пользователей уровень СОЗНАТЕЛЬНОЙ ЗАИНТЕРЕСОВАННОСТИ и ДОВЕРИЯ к результатам.
| Результат по трем методикам | ППО | Вес | Способ 1 (без поправки) | Способ 2 (с поправкой на случайное угадывание) |
| Тест 1 на А1 | 90 | 1000 | 900 | 867 |
| Тест 2 на А2 | 80 | 2000 | 1600 | 1467 |
| Тест 3 на B1 | 30 | 3000 | 900 | 200 |
| ОБЪЕМ (сумма) | 3400 | 2533 |
Таблица 1. Гипотетический испытуемый выполнил только три методики.
Разные тесты вносят разный вклад в оценку объема, так что более трудные тесты вносят более высокий вклад. Самый легкий тест 1 содержит слова из первой тысячи по частотному словарю, поэтому вес этого теста в общую сумму оказывается минимальным – он оказывается не больше 1000 очков, если испытуемый ответит на все 30 заданий правильно, то есть покажет балл ППО=100%. Но испытуемый в таблице 1 дал только 27 правильных ответов из 30 (ППО=90%), поэтому вклад первого теста оказался равным 900.
Следующий по трудности тест 2 содержит слова из 2-й и 3-й тысячи по частотному словарю, поэтому вес этого теста выше и равен уже 2000. Так как испытуемый показал 80% правильных ответов, то вклад второго теста оказывается равным 0,8*2000=1600. Тест 3 содержит слова из 4-й, 5-й и 6-й тысяч по частотному словарю, поэтому вес данного теста еще на тысячу больше.
Таким образом, в соответствии с упрощенным СПОСОБОМ 1 показатель ППО по каждому тесту надо умножить на вес и поделить на 100, а затем подсчитать сумму всех трех вкладов. Все это каждый пользователь легко может выполнить на простейшем калькуляторе. Таким образом, каждый может самостоятельно ПРОВЕРИТЬ, как подсчитывает словарный запас наша компьютерная система – сверить свои расчеты с автоматическими расчетами в своем личном кабинете. В тот случае, который описан в таблице 1, испытуемый показал по тесту 3 очень низкий балл, фактически близкий к минимально допустимому ППО=25%, поэтому дальнейшее тестирование можно было считать нецелесообразным — получался бы результат, который фактически попадал бы в область случайного угадывания (при четырех вариантов ответа балл ППО<25% следует считать случайным).
В таблице 2 приводится еще один расчетный пример. Но в этом случае испытуемый выполнил уже все пять методик – по всем пяти показал результат значительно выше 25%.
| Результат по пяти методикам | ППО | Вес | Способ 1 (без поправки) | Способ 2 (с поправкой на случайное угадывание) |
| Тест 1 на А1 | 100 | 1000 | 1000 | 1000 |
| Тест 2 на А2 | 93 | 2000 | 1860 | 1813 |
| Тест 3 на B1 | 73 | 3000 | 2190 | 1920 |
| Тест 4 на B2 | 70 | 4000 | 2800 | 2400 |
| Тест 5 на С1 | 60 | 5000 | 3000 | 2333 |
| ОБЪЕМ (сумма) | 10850 | 9467 |
Таблица 2. Гипотетический испытуемый выполнил все пять методик.
Надо сказать, что оценка объема, подсчитанная упрощенным способом 1, является завышенной, так как не включает поправку на случайное угадывание. Наши любознательные пользователи, которые не хотят сами себя обманывать и готовы воспользоваться для расчетов уже не простейшим калькулятором, а электронными таблицами, вполне могут освоить и способ 2. В этом случае вклад теста подсчитывается по следующей формуле:
Вклад = Вес*(ППО-25%)/(100%-25%),
Как вы понимаете, кроме Веса и ППО, в данной формуле участвует такой параметр, который отражает процент случайных правильных ответов. В нашем случае он равен 25%, так как в наших тестах четыре варианта ответов, но если их было бы пять, то этот параметр был бы равен 100%/5=20%.
Что дает такая поправка? – Рассмотрев более внимательно последний столбец в таблицах 1 и 2, мы видим, что вклад теста оказывается тем ниже, чем ближе ППО приближается к случайному уровню в 25%. Особенно резкий «штраф» получается у испытуемого 1 в третьем тесте: так ППО оказывается в данном случае очень близким к 25%, то вклад этого теста в оценку объема оказывается минимальным и равен только 200 словам (а вовсе не 900 словам, что дает нам упрощенный способ 1). Хотя по общей оценке объема испытуемый 1 остается внутри категории А2, но уже на грани с низшей категорией А1 (стартовый уровень овладения языком): его балл с поправкой равен только 2533, а нижняя граница для категории А2 – это 2500 слов.
При этом в таблице 2 мы видим, что без учета поправки самый высокий вклад дает тест №5 на уровень С1 (это 3000 очков). Тогда как с учетом поправки тест №5 уходит на второе место (только 2333 очка), а лидером становится тест №4 (дает вклад в размере 2400 очков).
ГРАНИЦЫ КАТЕГОРИЙ И ВЫБОР ТЕКСТОВ
В столбце 1 таблицы 3 указаны буквенные обозначения и нижние границы пяти категорий (Поясним, что высшую категорию С2, которая называется «профессиональное владение», как правило, не удается диагносцировать с помощью универсального и компактного метода скоростных тестов с выбором ответа-перевода, так как эта категория связана с освоением весьма специфичной лексики, отражающей профессиональную специализацию человека) .
Что означает термин «рецептивный словарь»? – Он означает, что это пассивный словарь, объем которого всегда оказывается значительно выше, чем объем активного словаря (вокабуляра). Дело в том, что тест с выбором ответа апеллирует к механизмам «памяти на узнавание» (в отличие от «памяти на воспроизведение»). Но ведь и в ходе чтения (прослушивания) текстов прежде всего работает «рецептивный словарь», так как контекст облегчает узнавание знакомых слов и понимание смысла малознакомых слов.
| Ваш запас слов | Текст A1 | Текст A2 | Текст B1 | Текст B2 | Текст C1 |
| A1 (>1500) | 🟢 0–2% | 🟡 5–8% | 🟠 12–15% | 🔴 22–26% | 🔴 32–36% |
| A2 (>2500) | 🟢 0-1% | 🟢 0–2% | 🟡 6–8% | 🟠 15–18% | 🔴 25–28% |
| B1 (>4000) | 🟢 0% | 🟢 0-1% | 🟢 1–3% | 🟡 8–10% | 🟠 18–20% |
| B2 (>6000) | 🟢 0% | 🟢 0% | 🟢 0–1% | 🟢 2–4% | 🟡 10–12% |
| C1 (>8000) | 🟢 0% | 🟢 0% | 🟢 0-1% | 🟢 0–2% | 🟢 2–4% |
Таблица 3 для выбора текстов (с учетом рецептивного словаря)
Легенда (светофор):
- 🟢 0–4% незнакомых слов: Комфортное чтение (покрытие 96–100%). Читается легко, без словаря.
- 🟡 5–12% незнакомых слов: Чтение с опорой на контекст (покрытие 88–95%). Понимание общее, но потребуется усидчивость.
- 🟠 13–20% незнакомых слов: Трудное чтение. Понимание фрагментарное, многое угадывается. Высокий риск бросить книгу.
- 🟠 > 20% незнакомых слов: Текст слишком сложен для самостоятельного чтения на данном этапе.
============================
Если у Вас будут вопросы по предложенным таблицам и формулам, задавайте их, пожалуйста, по адресу поддержки участников проекта КИТТ – kitt@ht.ru.
===========================
Примечание: при оформлении расчетных таблиц 1 и 2 и цветовой раскраске таблицы 3 авторский коллектив воспользовался помощью известной системы DeepSeek — ИИ-системы нейросетевого типа. Хотя при этом некоторые конкретные значения в этой таблице пришлось скорректировать, как и границы между категориями. Впрочем, после экспериментально прогона методике в клубе КИТТ эти границы могут быть еще раз скорректированными.
Добавить комментарий